Для обучения ИИ открыли корпус узбекского языка объёмом около 6 млрд слов
Министерство цифровых технологий Узбекистана разместило на Hugging Face открытый корпус узбекоязычных текстов — около 6 млрд слов из 5,6 млн документов. Набор предназначен для развития систем искусственного интеллекта, способных лучше понимать узбекский язык и создавать на нём контент.
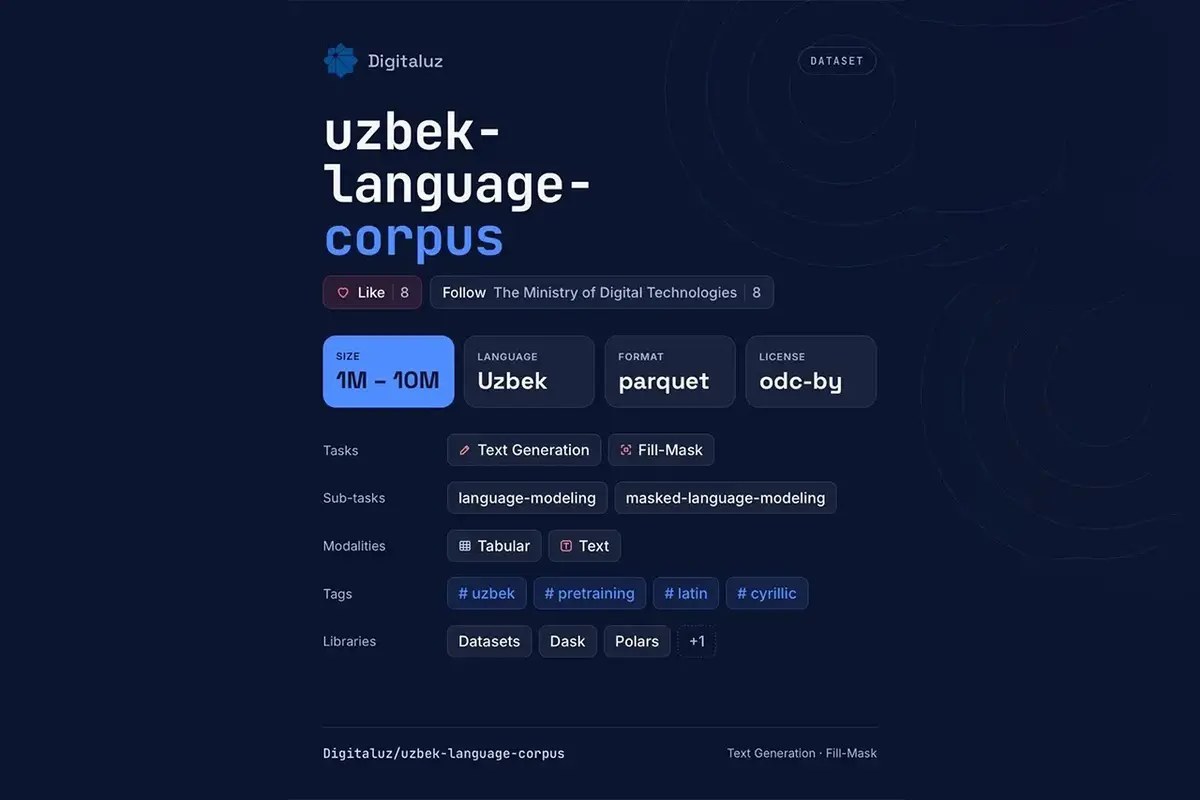
Корпус объединяет материалы в латинской и кириллической графике. В него вошли оцифрованные книги, газетные публикации, архивные тексты, законодательные документы, статьи Википедии, веб-страницы и открытые публикации в Telegram.
Перед размещением тексты обработали и отобрали по качеству, а затем распределили по отраслям и тематическим направлениям. По сообщению министерства, персональные данные заменили специальными обозначениями, в том числе [PHONE] для телефонных номеров и [NAME] для имён.
На странице набора Hugging Face отображается около 5,64 млн записей. Корпус представлен в формате Parquet, а среди полей доступны текст, источник, тематическая область, используемая графика и количество слов. Такие сведения позволяют разработчикам отбирать материалы под конкретные задачи обучения. Карточка корпуса.
Подобные наборы служат исходным материалом для языковых моделей: на больших объёмах текстов системы изучают закономерности языка, особенности словоупотребления и связи между понятиями. Поддержка обеих письменностей важна для работы с разнообразными узбекоязычными источниками.
Разработка стала частью исполнения поручения президента Шавката Мирзиёева, данного 21 октября 2025 года на совещании по ускоренному внедрению ИИ в государственное управление, экономику и регионы. Тогда глава государства подчеркнул необходимость полноценного понимания узбекского языка такими системами.
Министерство также работает над предоставлением корпуса разработчикам ведущих больших языковых моделей. Ведомство сообщило о начале сотрудничества с Qwen. Подробности использования набора и результаты его интеграции в модели пока не раскрыты.
Корпус доступен для загрузки на Hugging Face. В карточке указана лицензия Open Data Commons Attribution — ODC-BY, предусматривающая использование базы данных с указанием источника.